Auf der 27. RDA-Plenary-Versammlung (RDA P27) war NFDI4Chem an der Birds-of-a-Feather-Session „Harnessing automation and AI tools to advance data curation and connect digital research infrastructures“ beteiligt. Die Session wurde von Agnes Jasinska organisiert und moderiert. Neben NFDI4Chem stellten Ian Bruno (CCDC), Dieuwertje Bloemen (KU Leuven RDR), Nick Garland (Archaeology Data Service), Nicola Knight (Physical Sciences Data Infrastructure, PSDI) und Rory MacNeil (RSpace) ihre Perspektiven vor.
Datenkuration im Verbund von Diensten
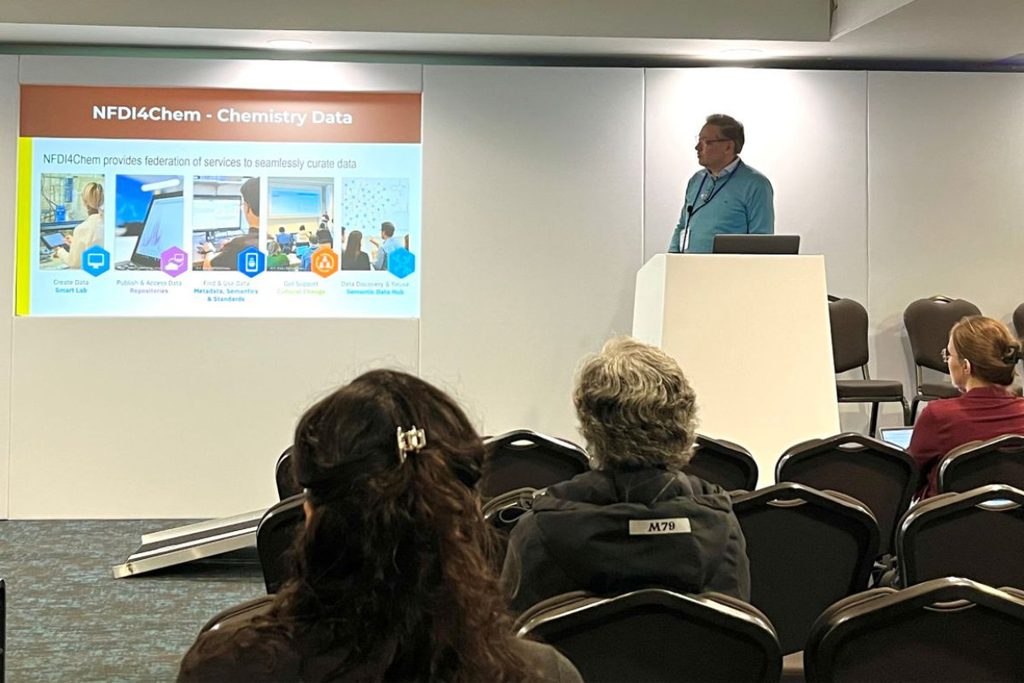
Unser Co-Speaker Oliver Koepler präsentierte, wie Forschungsdaten über einen Verbund aufeinander abgestimmter Dienste kuratiert werden.
- Im Labor: Maschinenlesbare Metadaten entstehen bereits im elektronischen Laborbuch Chemotion ELN.
- Semantische Annotation: Die Metadaten werden mit Ontologie-Begriffen aus dem Terminology Service angereichert.
- Publikation: Die Daten gelangen in Repositorien des Verbunds wie das Chemotion Repository, nmrXiv oder RADAR4Chem.
- Suche: Der NFDI4Chem Search Service harvestet diese Repositorien und ermöglicht eine zentrale Suche über alle Datensätze.
- Wissensgraph: Die Daten werden in chemDCAT-AP-serialisiertes RDF überführt und in den Chemistry Knowledge Graph eingespeist.
Automatisierung und KI entlang der Datenpipeline
Automatisierung und KI-Unterstützung sind in mehreren Stufen der NFDI4Chem-Datenpipeline verankert. Sie reichen von der Erfassung der Daten aus Messgeräten über Datenkonvertierung, Metadatenextraktion und -anreicherung bis hin zur KI-gestützten Zuweisung von Ontologie-Begriffen im ELN. Hinzu kommt die Datenvalidierung. Künftig sollen außerdem Abfragen des Knowledge Graph mithilfe von KI-Agenten möglich werden. In allen Fällen bleibt der Mensch eingebunden („human in the loop“).
Gemeinsame Erkenntnisse der Session
In der anschließenden Diskussion zeigten viele Übereinstimmungen: So übernimmt regelbasierte Automatisierung an vielen Stellen den Großteil der Routinearbeit. KI ist besonders dort hilfreich, wo sie Kuratorinnen und Kuratoren aufzeigt, worauf sie zuerst schauen sollten. Und mehrfach wurde betont, dass all dies gut kuratierte Daten und belastbare Standards voraussetzt.
Wie es weitergeht
Viele Teilnehmende möchten den Austausch über die unterschiedlichen Rollen von KI-Werkzeugen im Umgang mit Forschungsdaten fortsetzen. Als wahrscheinlicher nächster Schritt gilt die Gründung einer Arbeitsgruppe oder von Task Groups innerhalb einer übergreifenden KI-Gruppe der RDA. Vorgeschlagene Themen sind:
Vorgeschlagene Themen sind:
- Leitplanken („Guardrails“) für KI-Agenten in Forschungswerkzeugen
- Provenienz von Agentenaktionen und menschlichen Freigaben
- ein gemeinsames Rahmenwerk zur Bewertung von KI-Werkzeugen
- ein offener Austausch von Skripten und gesammelten Erfahrungen
Wir freuen uns auf die weitere gemeinsame Arbeit.